我的網誌
成為首家AI雲端供應商!成功整合數百個高效能GPU
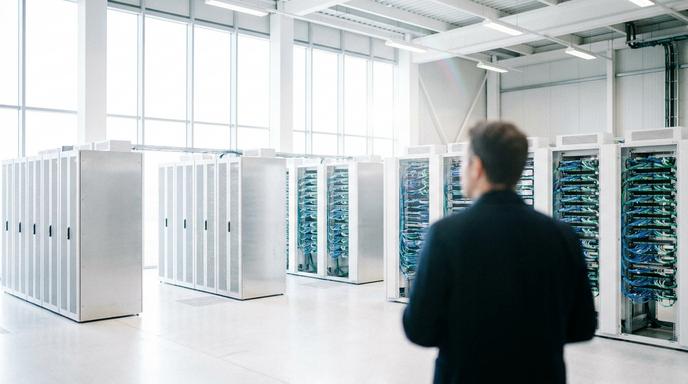
CoreWeave(CRWV)於週三宣布,已正式上線輝達(NVDA)的多機架Vera Rubin NVL72系統,將數百個Rubin GPU整合為單一的橫向擴展叢集,為人工智慧運算提供強大動力。這項最新進展延續了CoreWeave(CRWV)在今年六月初的宣示,當時該公司首度透露將成為第一家上線Vera Rubin NVL72系統的AI雲端服務供應商。受此消息激勵,CoreWeave(CRWV)週三早盤股價上漲3%,輝達(NVDA)股價也微幅走高約1%。
專為代理AI量身打造!大幅提升模型學習與迭代效率
CoreWeave(CRWV)產品與工程執行副總裁Chen Goldberg表示,作為首家驗證並導入Vera Rubin NVL72系統的雲端業者,證明了這種先進的機架級別架構,能夠作為可靠且高效能的雲端服務運作。她進一步指出,透過多機架的Vera Rubin系統連接數百個GPU,為正在開發「代理AI」的企業客戶帶來巨大優勢。這意味著在模型和代理持續學習改進的過程中,客戶能享有更大的擴充性、更快的迭代速度以及更高的生產力。
結合多項頂尖網路技術,打造無縫擴展的超級運算架構
從硬體規格來看,單一Vera Rubin NVL72機架配備了72個Rubin GPU、36個Vera CPU,並結合了NVLink 6、ConnectX-9 SuperNICs以及BlueField-4 DPUs等頂尖硬體。透過多機架部署,CoreWeave(CRWV)利用輝達(NVDA)的Spectrum-X乙太網路技術,將數百個加速器統一整合為單一的橫向擴展叢集。其中,Connect X-9 SuperNICs提供每組GPU高達1.6 Tb/s的連接速度,能在無阻塞的網路架構中支援每個軌道約128,000個GPU運作。這種模組化的網路拓撲設計,讓系統在未來擴充機架時,無需重新設計底層架構。
同步推出全新儲存功能,有效降低八倍資料延遲時間
除了硬體部署的重大進展,CoreWeave(CRWV)也同步公開了自家AI物件儲存服務的新功能,包含跨區域寫入加速以及全新的歸檔層級設計。這些創新功能旨在讓關鍵資料更貼近AI的運算工作負載,提升整體效率。該公司強調,透過每個CoreWeave Kubernetes服務節點上的託管快取機制,其本地物件傳輸加速器能將資料延遲時間大幅降低高達八倍,進一步鞏固其在AI基礎設施領域的競爭優勢。